Чат-бот по документам компании: как устроен RAG-поиск
Модель не знает ваших внутренних регламентов. RAG решает это: перед ответом система находит нужные фрагменты документов и отвечает строго по ним, со ссылкой на источник.
Типичная жалоба на корпоративного бота: «он отвечает уверенно и неправильно». Причина в том, что языковая модель не знает ваших документов и в ответ на вопрос про внутренний регламент выдаёт правдоподобное обобщение из открытых источников. Решение называется RAG — генерация с опорой на найденные документы.
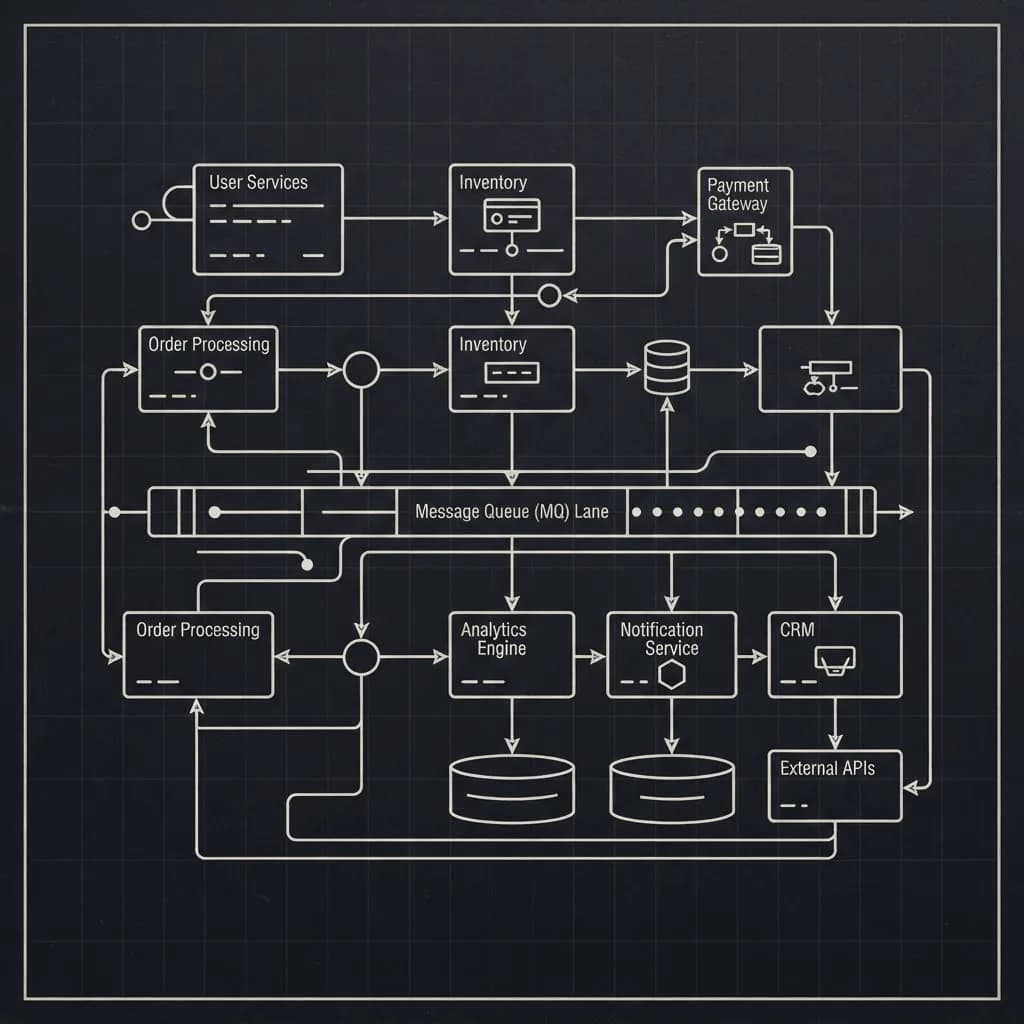
Как работает RAG
Идея простая: не полагаться на память модели, а перед каждым ответом найти в ваших документах подходящие фрагменты и передать их в запрос. Модель работает как аналитик, которому положили на стол нужные страницы, а не как эксперт, вспоминающий по памяти.
- Документы разбиваются на фрагменты по 300–800 слов с сохранением заголовков раздела.
- Каждый фрагмент превращается в вектор — числовое представление смысла — и сохраняется в базе.
- Вопрос пользователя тоже превращается в вектор, и система находит фрагменты с ближайшим смыслом.
- Найденные фрагменты подставляются в запрос, и модель формулирует ответ строго по ним.
- К ответу прикрепляются ссылки на документы-источники.
Подготовка документов — половина результата
Качество ответов определяется не моделью, а тем, как нарезаны документы. Самая частая ошибка — резать текст по фиксированному числу символов. Тогда пункт регламента разрывается посередине, и в базу попадает фрагмент, из которого невозможно понять условие.
- Режьте по смысловым границам: разделам, пунктам, абзацам. Заголовок раздела добавляйте в начало каждого фрагмента.
- Сохраняйте метаданные: название документа, дату, версию, подразделение. По ним потом фильтруется поиск.
- Отделяйте действующие документы от архивных. Ответ по отменённому регламенту хуже отсутствия ответа.
- Таблицы переводите в текстовое описание строк — иначе при нарезке они теряют шапку и смысл.
Код: индексация и поиск
Для хранения векторов достаточно PostgreSQL с расширением pgvector — отдельная векторная база на объёмах до сотен тысяч фрагментов не нужна. Ниже структура таблицы и запрос поиска.
create extension if not exists vector;

create table doc_chunks (
  id          bigserial primary key,
  document_id text not null,
  title       text not null,
  section     text,
  content     text not null,
  -- 1536 — размерность вектора для text-embedding-3-small
  embedding   vector(1536) not null,
  is_active   boolean not null default true,
  updated_at  timestamptz not null default now()
);

-- Индекс для быстрого поиска по косинусному расстоянию
create index doc_chunks_embedding_idx
  on doc_chunks using hnsw (embedding vector_cosine_ops);

-- Фильтрация по актуальности выносится в отдельный индекс
create index doc_chunks_active_idx on doc_chunks (is_active);import { embed, generateText } from "ai"
import { sql } from "@/lib/db"
export async function answerFromDocs(question: string) {
// 1. Вектор вопроса
const { embedding } = await embed({
model: "openai/text-embedding-3-small",
value: question,
})
// 2. Пять ближайших фрагментов среди действующих документов
const chunks = await sql`
select title, section, content,
1 - (embedding <=> ${JSON.stringify(embedding)}::vector) as score
from doc_chunks
where is_active = true
order by embedding <=> ${JSON.stringify(embedding)}::vector
limit 5
`
// 3. Отсекаем слабые совпадения: лучше признать незнание,
// чем отвечать по нерелевантному фрагменту
const relevant = chunks.filter((c) => c.score > 0.75)
if (relevant.length === 0) {
return { answer: "В документах нет ответа на этот вопрос.", sources: [] }
}
const context = relevant
.map((c, i) => `[${i + 1}] ${c.title} / ${c.section}\n${c.content}`)
.join("\n\n")
const { text } = await generateText({
model: "openai/gpt-4.1",
system: [
"Отвечай строго по приведённым фрагментам документов.",
"Если ответа в них нет — так и скажи.",
"После каждого утверждения ставь номер источника в квадратных скобках.",
].join(" "),
prompt: `Фрагменты:\n${context}\n\nВопрос: ${question}`,
})
return { answer: text, sources: relevant.map((c) => c.title) }
}Как проверять качество
Перед запуском мы собираем набор из пятидесяти-ста реальных вопросов с проверенными ответами и прогоняем систему по нему после каждого изменения. Без такого набора любая правка промпта или размера фрагмента превращается в угадывание.
| Метрика | Что показывает | Целевое значение |
|---|---|---|
| Точность поиска | Нужный фрагмент попал в выдачу | Выше 90 процентов |
| Обоснованность | Каждое утверждение опирается на источник | 100 процентов |
| Доля отказов | Система признала, что ответа нет | 5–15 процентов — норма |
| Время ответа | От вопроса до полного текста | До 4 секунд |
Сколько это стоит в эксплуатации
Векторизация архива из десяти тысяч страниц обходится примерно в двести–четыреста рублей и делается один раз. Дальше платите только за вопросы: одно обращение с пятью фрагментами контекста стоит порядка тридцати–восьмидесяти копеек. Тысяча вопросов в месяц — меньше тысячи рублей, и это обычно неожиданно мало для заказчиков.
Реальные затраты сосредоточены в подготовке документов и настройке нарезки. Если архив разнородный — сканы, таблицы, письма — эта часть занимает больше времени, чем вся остальная разработка.
Частые вопросы
- Почему ИИ придумывает ответы про наши внутренние документы?
- Модель не имеет доступа к вашим документам и в ответ на вопрос о внутреннем регламенте формирует правдоподобное обобщение из общедоступных источников. Решение — архитектура RAG: перед ответом система находит релевантные фрагменты ваших документов и передаёт их в запрос, а модель отвечает строго по ним со ссылкой на источник.
- Нужна ли отдельная векторная база данных?
- На объёмах до сотен тысяч фрагментов достаточно PostgreSQL с расширением pgvector и индексом HNSW. Отдельная векторная база оправдана при значительно больших объёмах или особых требованиях к скорости поиска.
- Сколько стоит чат-бот по базе знаний в эксплуатации?
- Векторизация архива из десяти тысяч страниц обходится в двести–четыреста рублей и выполняется однократно. Одно обращение с пятью фрагментами контекста стоит примерно тридцать–восемьдесят копеек, то есть тысяча вопросов в месяц — менее тысячи рублей. Основные затраты приходятся на подготовку и нарезку документов.
- Как понять, что бот отвечает правильно?
- Нужен тестовый набор из пятидесяти-ста реальных вопросов с проверенными ответами, по которому система прогоняется после каждого изменения. Измеряются точность поиска, обоснованность ответов ссылками на источники, доля честных отказов и время ответа.
Похожая задача в вашем проекте?
Разберём вашу ситуацию и пришлём оценку по этапам — без обязательств и общих слов.
Обсудить задачу